SAS-히스토그램
히스토그램은 높이가 다른 막대를 사용하여 데이터를 그래픽으로 표시 한 것입니다. 데이터 세트의 다양한 숫자를 여러 범위로 그룹화합니다. 또한 연속 변수의 분포 확률 추정치를 나타냅니다. SAS에서PROC UNIVARIATE 아래 옵션으로 히스토그램을 생성하는 데 사용됩니다.
통사론
SAS에서 히스토그램을 생성하는 기본 구문은 다음과 같습니다.
PROC UNIVARAITE DATA = DATASET;
HISTOGRAM variables;
RUN;DATASET 사용 된 데이터 세트의 이름입니다.
variables 히스토그램을 그리는 데 사용되는 값입니다.
단순 히스토그램
값을 그룹화하기 위해 고려할 변수 이름과 범위를 지정하여 간단한 히스토그램을 만듭니다.
예
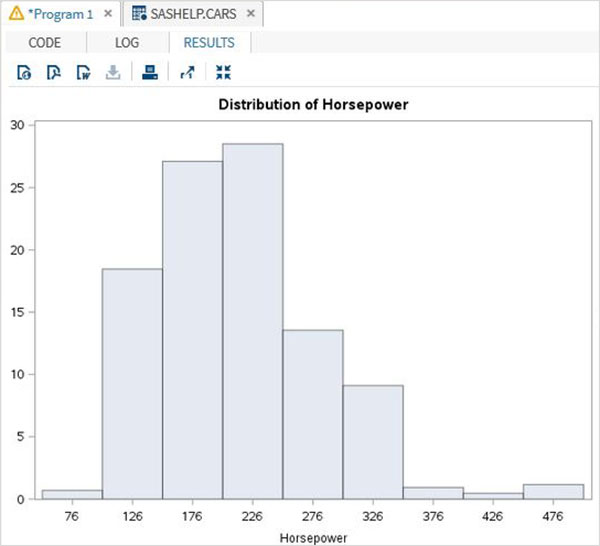
아래 예에서는 가변 마력의 최소값과 최대 값을 고려하고 범위를 50으로 설정합니다. 따라서 값은 50 단계로 그룹을 형성합니다.
proc univariate data = sashelp.cars;
   histogram horsepower
   / midpoints = 176 to 350 by 50;
run;
위의 코드를 실행하면 다음과 같은 결과가 나옵니다.
곡선 피팅이있는 히스토그램
추가 옵션을 사용하여 일부 분포 곡선을 히스토그램에 맞출 수 있습니다.
예
아래 예에서는 EST로 언급 된 평균 및 표준 편차 값을 사용하여 분포 곡선을 맞 춥니 다. 이 옵션은 매개 변수를 사용하고 추정합니다.
proc univariate data = sashelp.cars noprint;
histogram horsepower
/
normal (
   mu = est
   sigma = est
   color = blue
   w = 2.5
)
barlabel = percent
midpoints = 70 to 550 by 50;
run;
위의 코드를 실행하면 다음과 같은 결과가 나옵니다.
