AVRO-클래스 생성을 통한 직렬화
스키마에 해당하는 클래스를 생성하거나 파서 라이브러리를 사용하여 Avro 스키마를 프로그램으로 읽을 수 있습니다. 이 장에서는 스키마를 읽는 방법에 대해 설명합니다.by generating a class 과 Serializing Avr을 사용하는 데이터.

클래스를 생성하여 직렬화
Avro를 사용하여 데이터를 직렬화하려면 다음 단계를 따르십시오.
Avro 스키마를 작성합니다.
Avro 유틸리티를 사용하여 스키마를 컴파일합니다. 해당 스키마에 해당하는 Java 코드를 얻습니다.
스키마를 데이터로 채 웁니다.
Avro 라이브러리를 사용하여 직렬화하십시오.
스키마 정의
다음과 같은 세부 사항을 가진 스키마를 원한다고 가정하십시오.
| Field | 이름 | 신분증 | 나이 | 봉급 | 주소 |
| type | 끈 | int | int | int | 끈 |
아래와 같이 Avro 스키마를 생성합니다.
다른 이름으로 저장 emp.avsc.
{
   "namespace": "tutorialspoint.com",
   "type": "record",
   "name": "emp",
   "fields": [
      {"name": "name", "type": "string"},
      {"name": "id", "type": "int"},
      {"name": "salary", "type": "int"},
      {"name": "age", "type": "int"},
      {"name": "address", "type": "string"}
   ]
}
스키마 컴파일
Avro 스키마를 생성 한 후 Avro 도구를 사용하여 생성 된 스키마를 컴파일해야합니다. avro-tools-1.7.7.jar 도구가 들어있는 항아리입니다.
Avro 스키마를 컴파일하는 구문
java -jar <path/to/avro-tools-1.7.7.jar> compile schema <path/to/schema-file> <destination-folder>홈 폴더에서 터미널을 엽니 다.
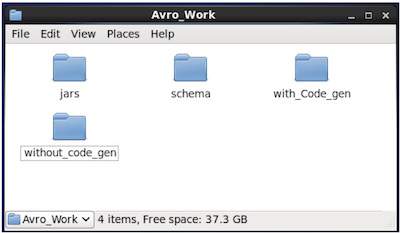
아래와 같이 Avro로 작업 할 새 디렉토리를 만듭니다.
$ mkdir Avro_Work새로 생성 된 디렉토리에 세 개의 하위 디렉토리를 생성합니다.
첫 번째 이름 schema, 스키마를 배치합니다.
두 번째 이름 with_code_gen, 생성 된 코드를 배치합니다.
세 번째 이름 jars, jar 파일을 배치합니다.
$ mkdir schema
$ mkdir with_code_gen
$ mkdir jars
다음 스크린 샷은 Avro_work 모든 디렉토리를 생성 한 후 폴더는 다음과 같아야합니다.
지금 /home/Hadoop/Avro_work/jars/avro-tools-1.7.7.jar avro-tools-1.7.7.jar 파일을 다운로드 한 디렉토리의 경로입니다.
/home/Hadoop/Avro_work/schema/ 스키마 파일 emp.avsc가 저장된 디렉토리의 경로입니다.
/home/Hadoop/Avro_work/with_code_gen 생성 된 클래스 파일을 저장할 디렉토리입니다.
이제 아래와 같이 스키마를 컴파일하십시오.
$ java -jar /home/Hadoop/Avro_work/jars/avro-tools-1.7.7.jar compile schema /home/Hadoop/Avro_work/schema/emp.avsc /home/Hadoop/Avro/with_code_gen컴파일 후 스키마의 네임 스페이스에 따른 패키지가 대상 디렉토리에 생성됩니다. 이 패키지 내에 스키마 이름이있는 Java 소스 코드가 생성됩니다. 이 생성 된 소스 코드는 애플리케이션에서 직접 사용할 수있는 주어진 스키마의 Java 코드입니다.
예를 들어,이 경우 패키지 / 폴더는 tutorialspoint com (네임 스페이스가 tutorialspoint.com이기 때문에)이라는 다른 폴더가 포함 된 폴더가 생성되고 그 안에서 생성 된 파일을 관찰 할 수 있습니다. emp.java. 다음 스냅 샷은emp.java −

이 클래스는 스키마에 따라 데이터를 생성하는 데 유용합니다.
생성 된 클래스에는-
- 기본 생성자 및 스키마의 모든 변수를 허용하는 매개 변수화 된 생성자.
- 스키마의 모든 변수에 대한 setter 및 getter 메서드.
- 스키마를 반환하는 Get () 메서드.
- 빌더 방법.
데이터 생성 및 직렬화
먼저이 프로젝트에서 사용 된 생성 된 자바 파일을 현재 디렉토리에 복사하거나 해당 파일이있는 곳에서 가져옵니다.
이제 새 Java 파일을 작성하고 생성 된 파일에서 클래스를 인스턴스화 할 수 있습니다 (emp)을 클릭하여 직원 데이터를 스키마에 추가합니다.
apache Avro를 사용하여 스키마에 따라 데이터를 생성하는 절차를 살펴 보겠습니다.
1 단계
생성 된 인스턴스화 emp 수업.
emp e1=new emp( );2 단계
setter 메서드를 사용하여 첫 번째 직원의 데이터를 삽입합니다. 예를 들어 Omar라는 직원의 세부 정보를 만들었습니다.
e1.setName("omar");
e1.setAge(21);
e1.setSalary(30000);
e1.setAddress("Hyderabad");
e1.setId(001);
마찬가지로 setter 메서드를 사용하여 모든 직원 세부 정보를 입력합니다.
3 단계
개체 만들기 DatumWriter 인터페이스를 사용하여 SpecificDatumWriter수업. 이것은 Java 객체를 메모리 내 직렬화 된 형식으로 변환합니다. 다음 예제는 인스턴스화합니다.SpecificDatumWriter 클래스 객체 emp 수업.
DatumWriter<emp> empDatumWriter = new SpecificDatumWriter<emp>(emp.class);4 단계
인스턴스화 DataFileWriter ...에 대한 emp수업. 이 클래스는 스키마 자체와 함께 스키마를 따르는 데이터의 시퀀스 직렬화 된 레코드를 파일에 씁니다. 이 수업에는DatumWriter 생성자에 대한 매개 변수로 객체.
DataFileWriter<emp> empFileWriter = new DataFileWriter<emp>(empDatumWriter);5 단계
다음을 사용하여 지정된 스키마와 일치하는 데이터를 저장할 새 파일을 엽니 다. create()방법. 이 메소드에는 스키마와 데이터가 저장 될 파일의 경로가 매개 변수로 필요합니다.
다음 예에서 스키마는 getSchema() 방법, 데이터 파일은 경로에 저장됩니다- /home/Hadoop/Avro/serialized_file/emp.avro.
empFileWriter.create(e1.getSchema(),new File("/home/Hadoop/Avro/serialized_file/emp.avro"));6 단계
다음을 사용하여 생성 된 모든 레코드를 파일에 추가합니다. append() 아래와 같이 방법-
empFileWriter.append(e1);
empFileWriter.append(e2);
empFileWriter.append(e3);
예 – 클래스를 생성하여 직렬화
다음 전체 프로그램은 Apache Avro를 사용하여 데이터를 파일로 직렬화하는 방법을 보여줍니다.
import java.io.File;
import java.io.IOException;

import org.apache.avro.file.DataFileWriter;
import org.apache.avro.io.DatumWriter;
import org.apache.avro.specific.SpecificDatumWriter;

public class Serialize {
   public static void main(String args[]) throws IOException{

      //Instantiating generated emp class
      emp e1=new emp();

      //Creating values according the schema
      e1.setName("omar");
      e1.setAge(21);
      e1.setSalary(30000);
      e1.setAddress("Hyderabad");
      e1.setId(001);

      emp e2=new emp();

      e2.setName("ram");
      e2.setAge(30);
      e2.setSalary(40000);
      e2.setAddress("Hyderabad");
      e2.setId(002);

      emp e3=new emp();

      e3.setName("robbin");
      e3.setAge(25);
      e3.setSalary(35000);
      e3.setAddress("Hyderabad");
      e3.setId(003);

      //Instantiate DatumWriter class
      DatumWriter<emp> empDatumWriter = new SpecificDatumWriter<emp>(emp.class);
      DataFileWriter<emp> empFileWriter = new DataFileWriter<emp>(empDatumWriter);

      empFileWriter.create(e1.getSchema(), new File("/home/Hadoop/Avro_Work/with_code_gen/emp.avro"));

      empFileWriter.append(e1);
      empFileWriter.append(e2);
      empFileWriter.append(e3);

      empFileWriter.close();

      System.out.println("data successfully serialized");
   }
}
생성 된 코드가있는 디렉토리를 탐색하십시오. 이 경우home/Hadoop/Avro_work/with_code_gen.
In Terminal −
$ cd home/Hadoop/Avro_work/with_code_gen/In GUI −
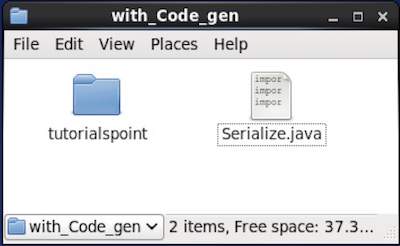
이제 위의 프로그램을 복사하여 이름이 지정된 파일에 저장하십시오. Serialize.java
아래와 같이 컴파일하고 실행하십시오-
$ javac Serialize.java
$ java Serialize
산출
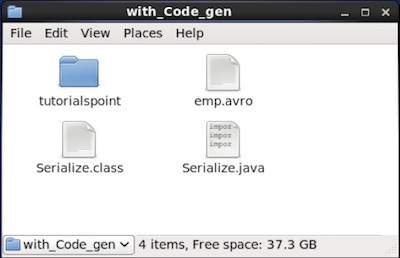
data successfully serialized프로그램에 주어진 경로를 확인하면 아래와 같이 생성 된 직렬화 파일을 찾을 수 있습니다.